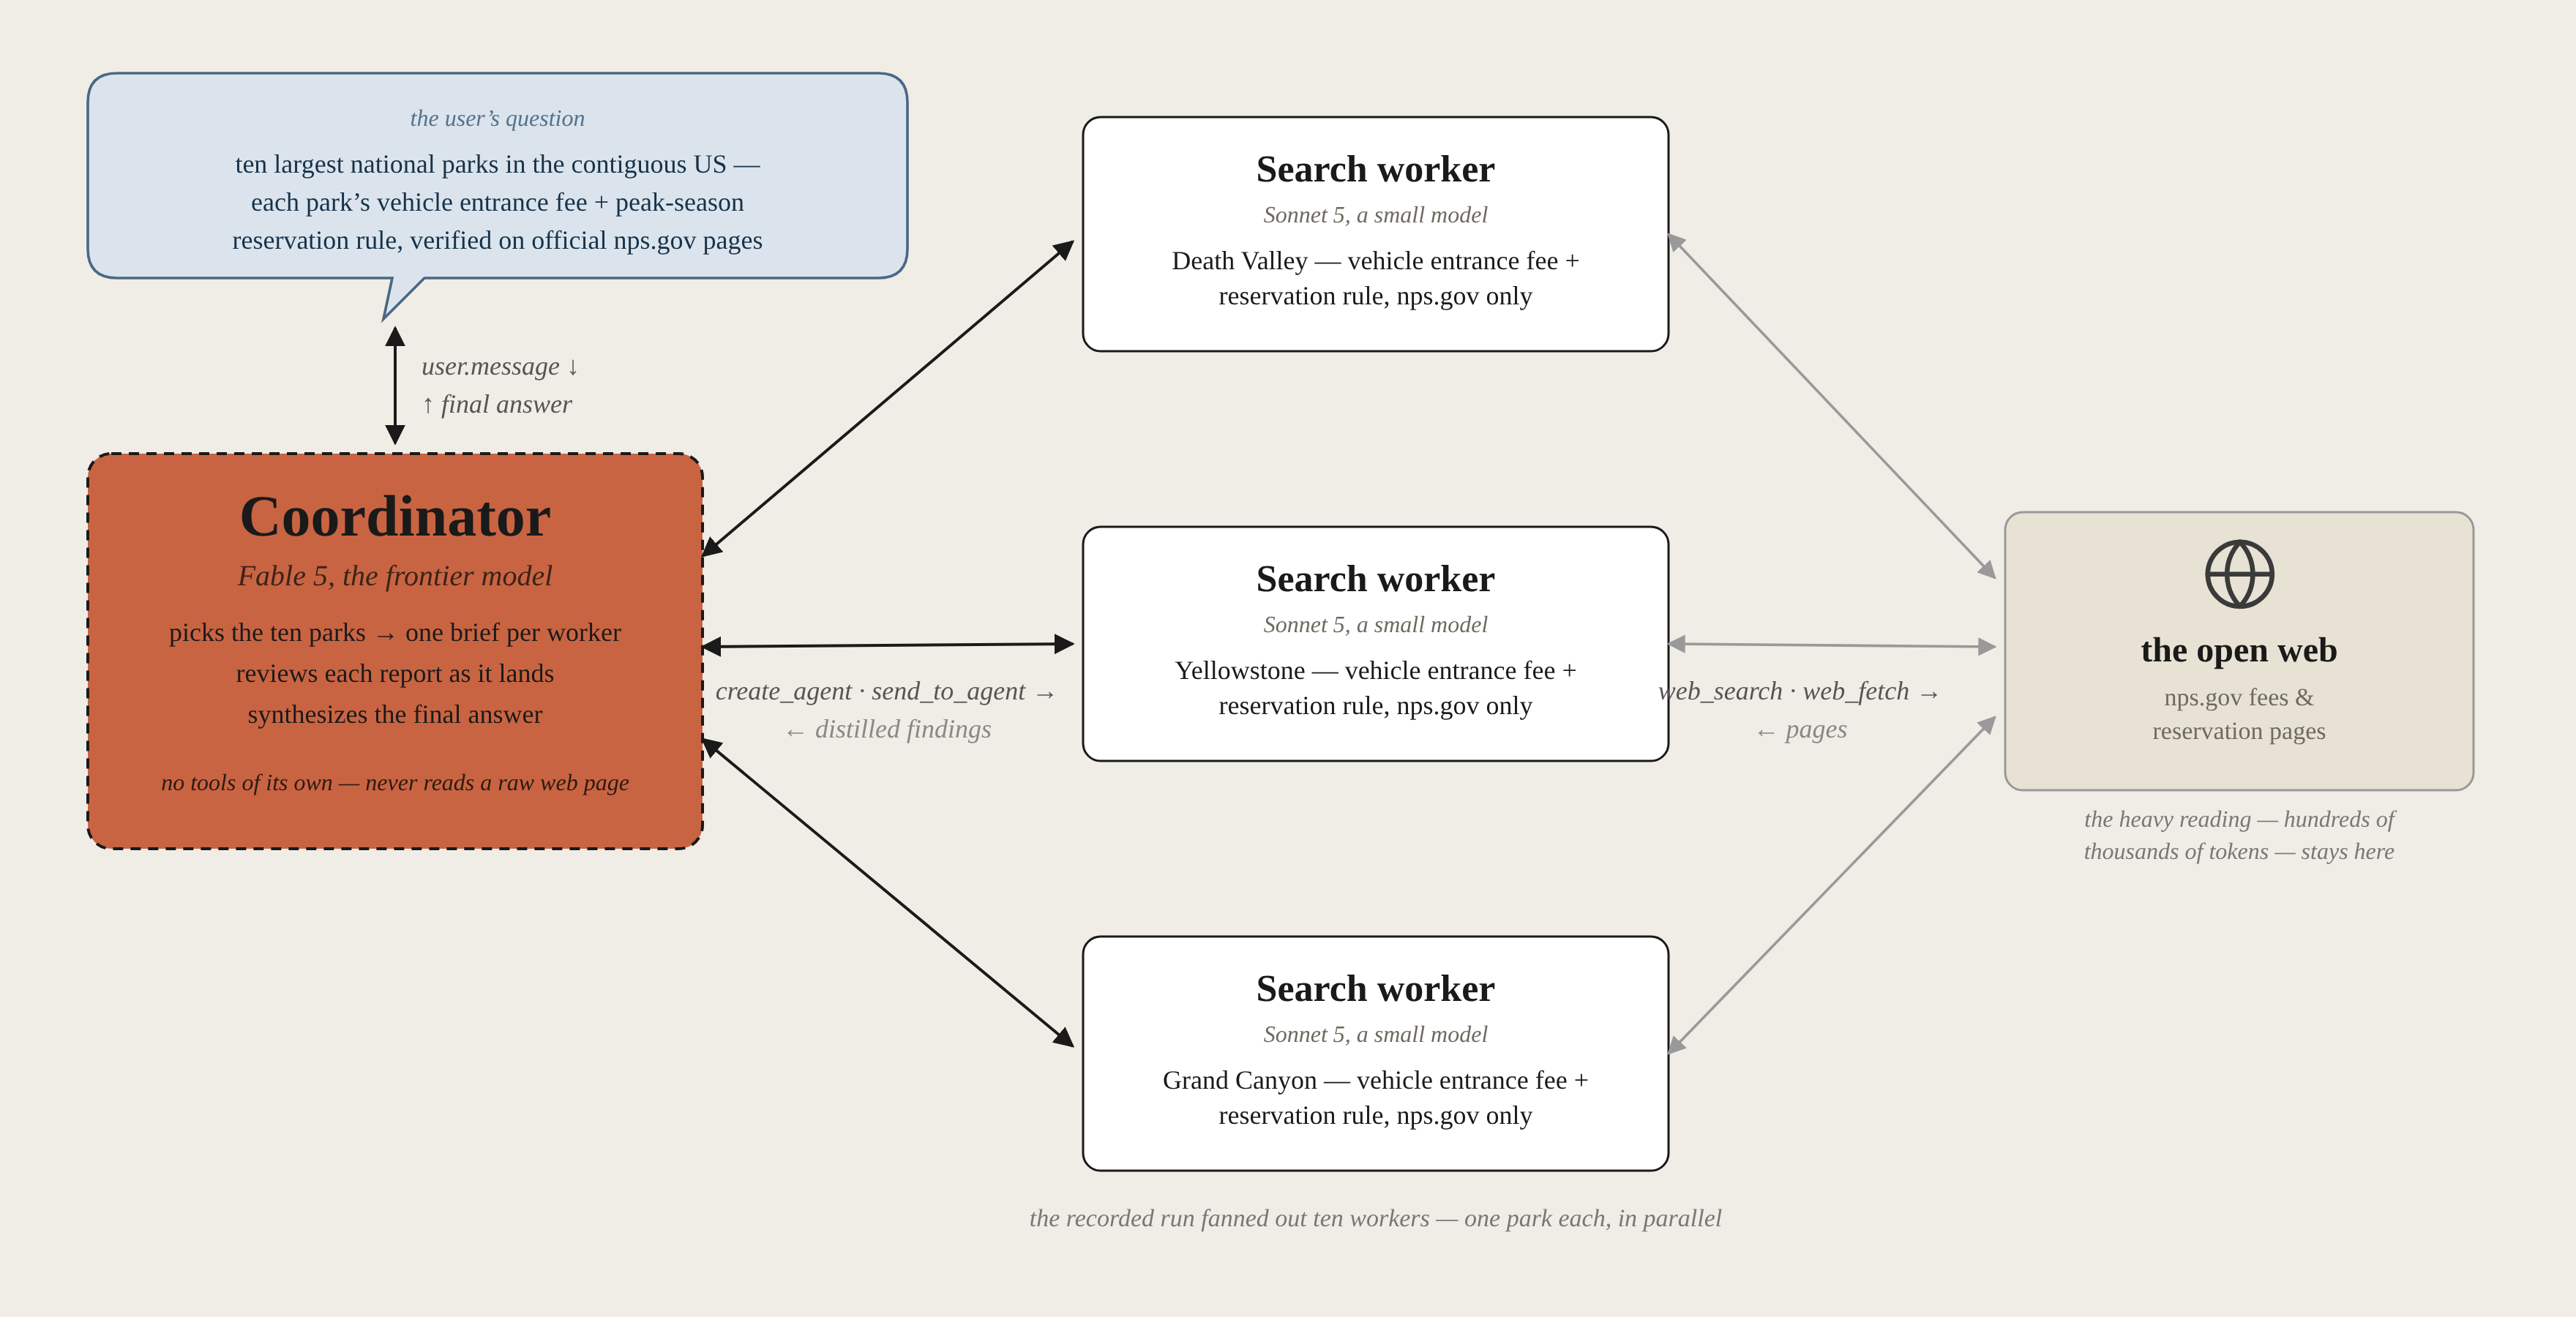
你的 AI agent 很貴,問題可能不是它不夠聰明
同一道題、同一個驗證標準,一個團隊付 $4,另一個付 $1.6。差別只在:貴的那個,讓最聰明的模型自己去讀網頁。
Claude Code 團隊把自家 system prompt 刪掉超過 80%,coding eval 沒有任何可測量的退步。過去兩年被奉為圭臬的六條 context engineering 規則,對新一代模型已經變成負擔——這篇是 Thariq 原文的中文編譯,含 CLAUDE.md 與 Skills 的具體改寫方向。
2026/7/26 · AI · X Article同一道題、同一個驗證標準,一個團隊付 $4,另一個付 $1.6。差別只在:貴的那個,讓最聰明的模型自己去讀網頁。
Boris Cherny 看 Claude Code 團隊,提煉出五種原型:Prototyper、Builder、Sweeper、Grower、Maintainer。新產品要 1+2+3、找到 PMF 要 2+3+4+一點 5、成熟產品要 3+4+5+一點 2。這篇把它接到台灣團隊、Sammy 自己的 OpenClaw 流程、以及一個比職稱更實用的招募判準。
Sandy Lee 沒技術背景,憑 AI SEO 顧問、YouTube 贊助、自己做的工具與付費社群,6 個月衝到月入 48K 美元。本文拆解她的收入結構與對工程師的啟示。
Kun(曾 Meta/Microsoft principal engineer)公開他的 AI agent workflow:每天 ship 40-50 個 PR,關鍵不是 agent 多強,是他把「中間實作」外包給 crew,自己只留「前端規劃+後端把關」。這篇把這個轉變命名為 Crew Captain Shift,給正在用 AI 但還沒意識到自己角色已經變的人。

OpenAI 逐題 audit SWE-Bench Pro,估計約 30% 任務是壞的,並撤回八個月前自己的推薦。這篇談的是「驗證債」:每一個被引用卻沒人驗證過的分數都是負債,遲早有人要還。
「AI 會不會讓我的孩子失去未來?」這種問題,沒有任何一家 AI 公司的表單能填。Anthropic 為它開了常設入口並承諾公開作答——但承諾不值錢,反悔成本才值錢。照這個標準看,連 Anthropic 自己都還沒過關。
64 個 Claude 實例、11 天,Bun 把 535,496 行 Zig 全量改寫成 Rust 並出貨 v1.4.0。真正被翻掉的不是 Spolsky 那條規則,而是程式碼的資產地位——測試才是資產,程式碼只是可以重印的耗材。
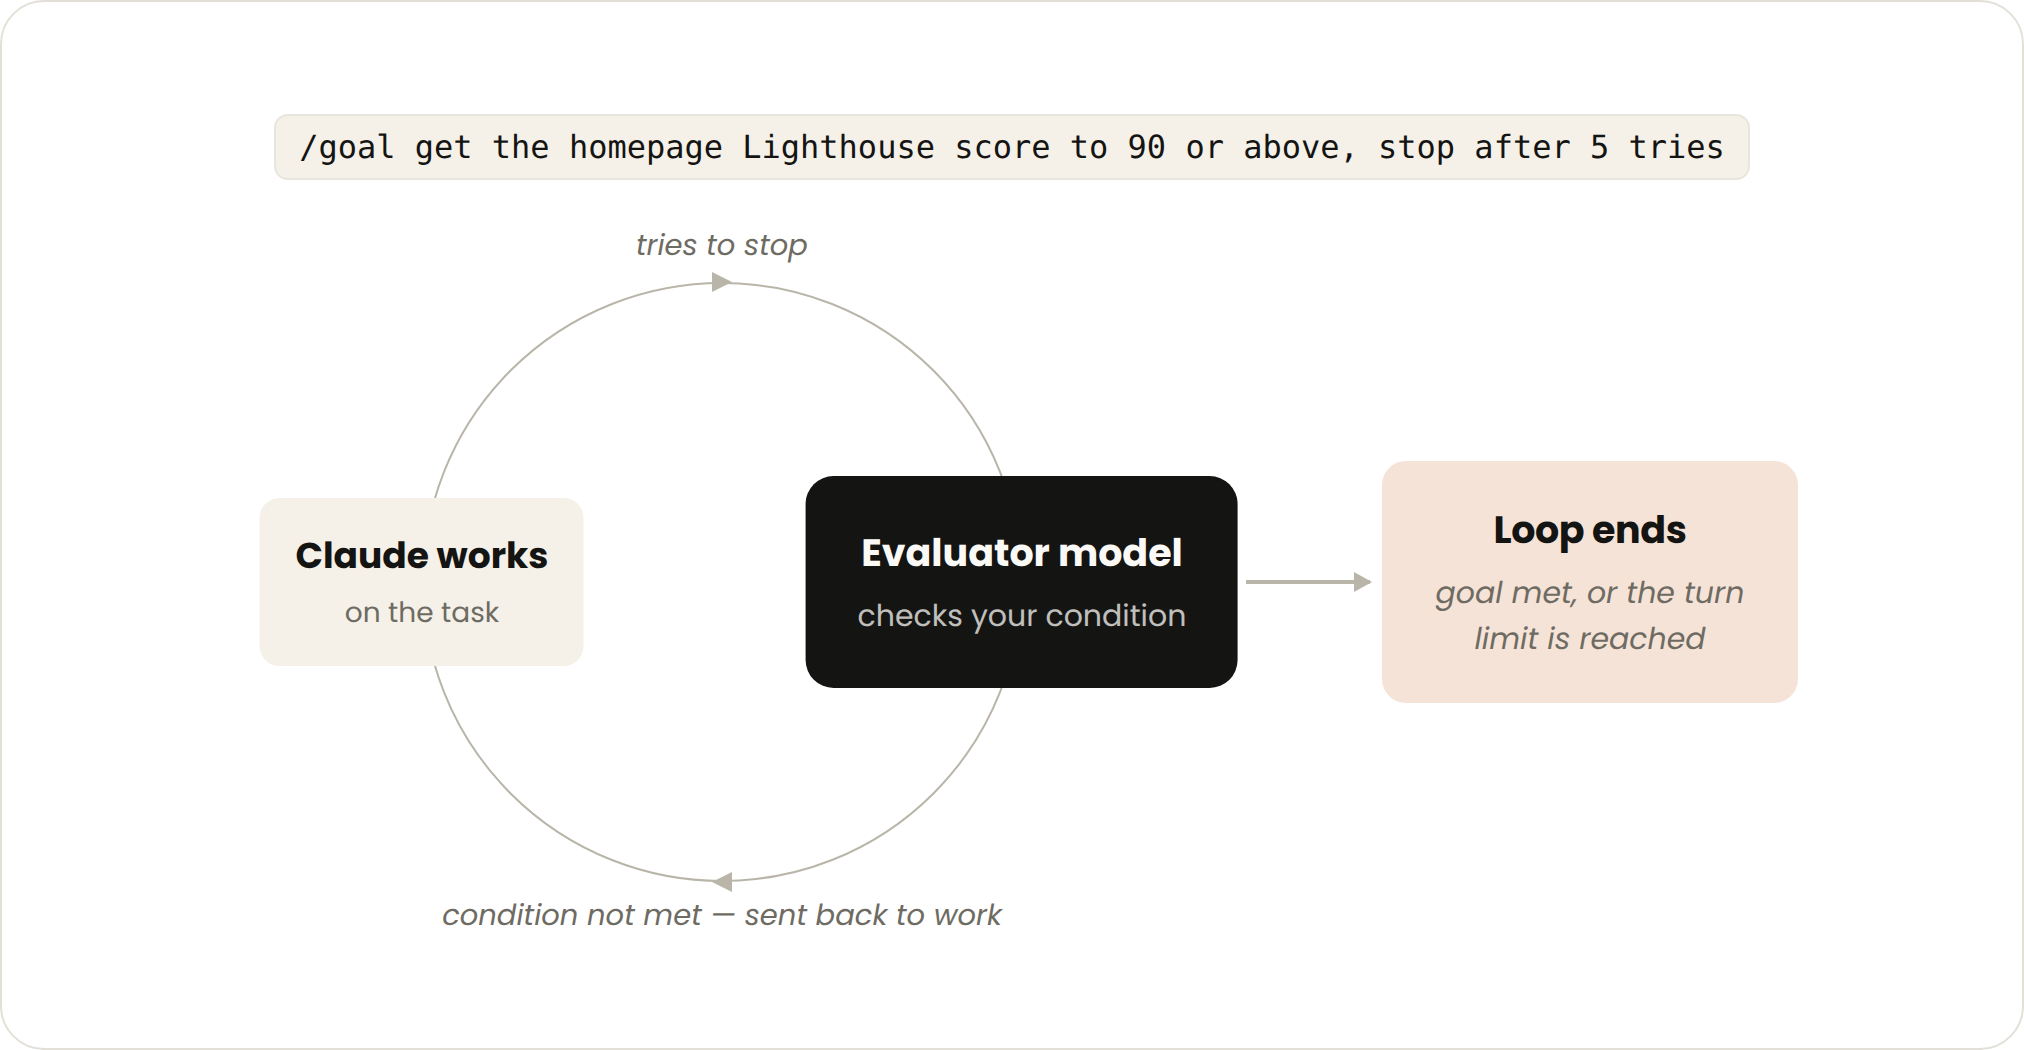
「Loop = agent 重複工作循環,直到滿足停止條件。」官方教學給了四個檔位:對話式、/goal、/loop 與 /schedule、主動式。這篇拆成可直接照做的四步,每檔附確切指令——重點不是 AI 多聰明,是你把「什麼時候停」交給誰。